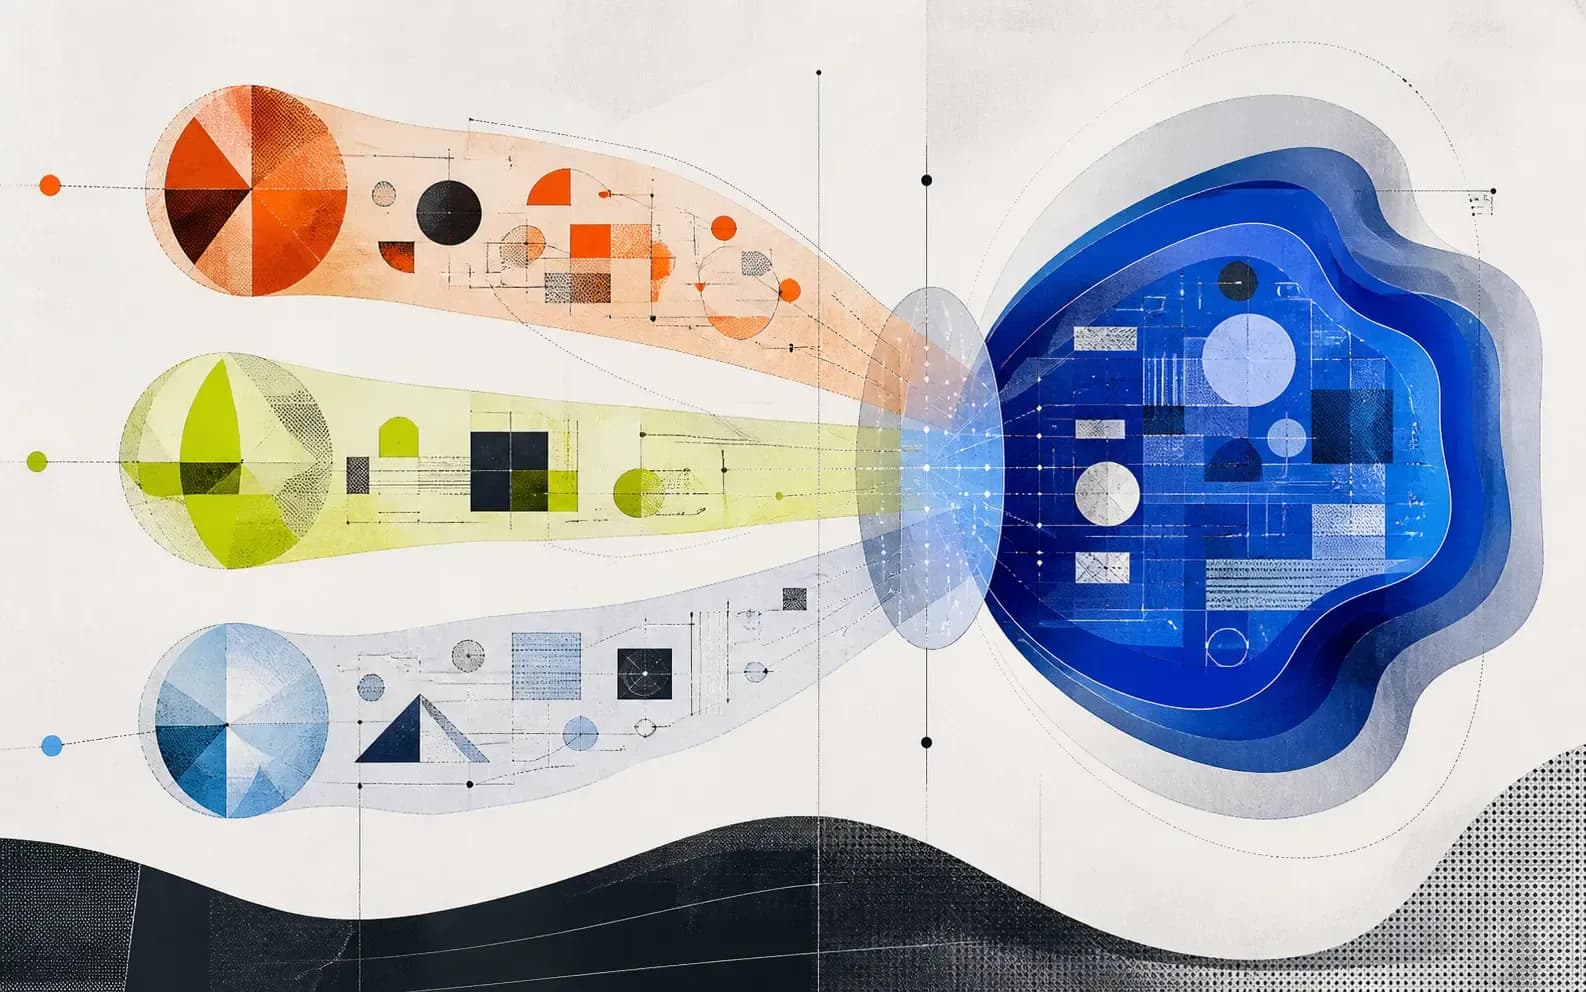
Диаризация отвечает на вопрос «кто говорил когда»: она делит запись на сегменты и группирует их по голосам, но сама по себе не всегда знает реальные имена.
Сначала система находит участки речи
Запись делится на интервалы с речью и без нее. Затем модель ищет смену говорящего и сравнивает голосовые признаки между сегментами.
Похожие сегменты объединяются
Результат обычно выглядит как условные участники: Speaker 1, Speaker 2 и далее. Реальное имя появляется только при дополнительной привязке или подтверждении.
Перекрытия остаются сложным случаем
Если люди говорят одновременно, запись с дальнего микрофона смешивает голоса. Ошибки также растут при шуме, коротких репликах и похожих голосах.
- Шум и эхо.
- Одновременная речь.
- Очень короткие ответы.
- Смена устройства или канала.
Важные атрибуции нужно проверять
Для аналитики достаточно устойчиво различать роли в большинстве фрагментов. Для обещаний, цитат и персональной оценки полезна ссылка на исходный звук и возможность исправления.
Об авторе
Антон Ковалевский
Маркетинг в Sonarsense.io
Пишу про то, что происходит в звонках отдела продаж, а не в отчётах CRM.