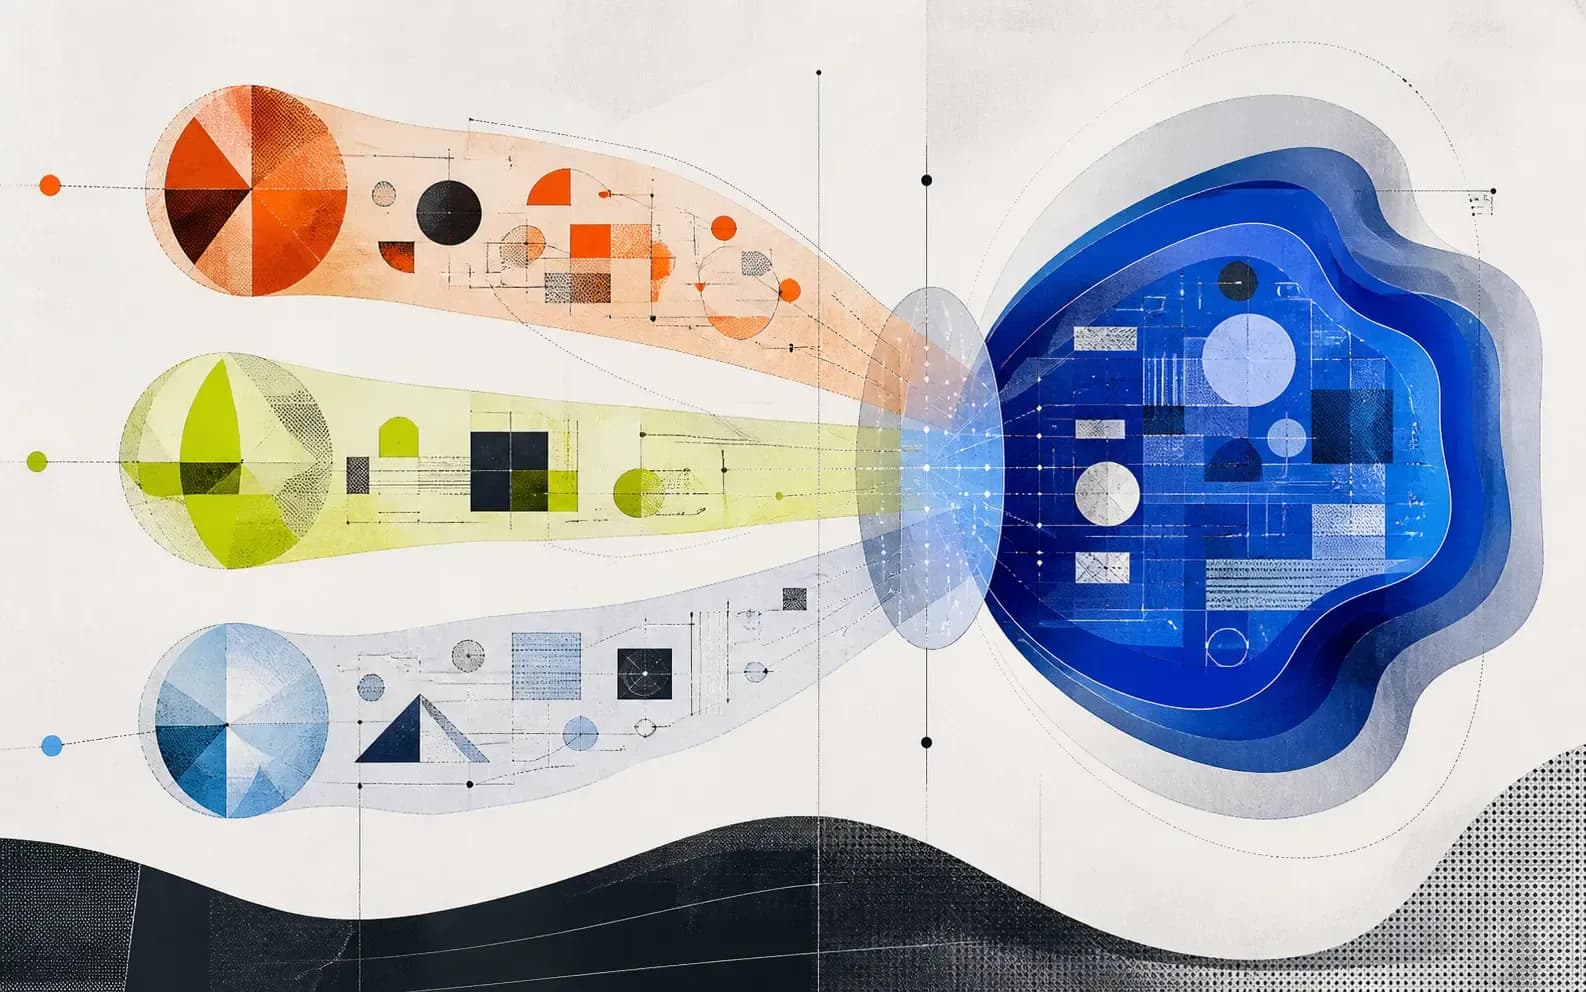
Транскрибация проходит несколько этапов: подготовка аудио, распознавание речи, расстановка временных границ, определение участников и проверка терминов.
Аудио сначала нужно подготовить
Качество записи, перекрывающаяся речь, шум и расстояние до микрофона влияют на результат до работы языковой модели. Поэтому одинаковый алгоритм может вести себя по-разному на студийной записи и в переговорной.
Модель превращает звук в последовательность слов
Система оценивает вероятные фрагменты речи и собирает их в текст. Контекст, язык и словарь терминов помогают распознавать названия продуктов, аббревиатуры и редкие имена.
Текст обогащается структурой
Для бизнеса важны временные метки, границы реплик и связь с говорящим. Без этой структуры трудно открыть нужный момент или понять, кому принадлежит обещание.
- Временные сегменты.
- Разделение говорящих.
- Пунктуация и абзацы.
- Поиск по терминам.
Ошибку нужно учитывать в продукте
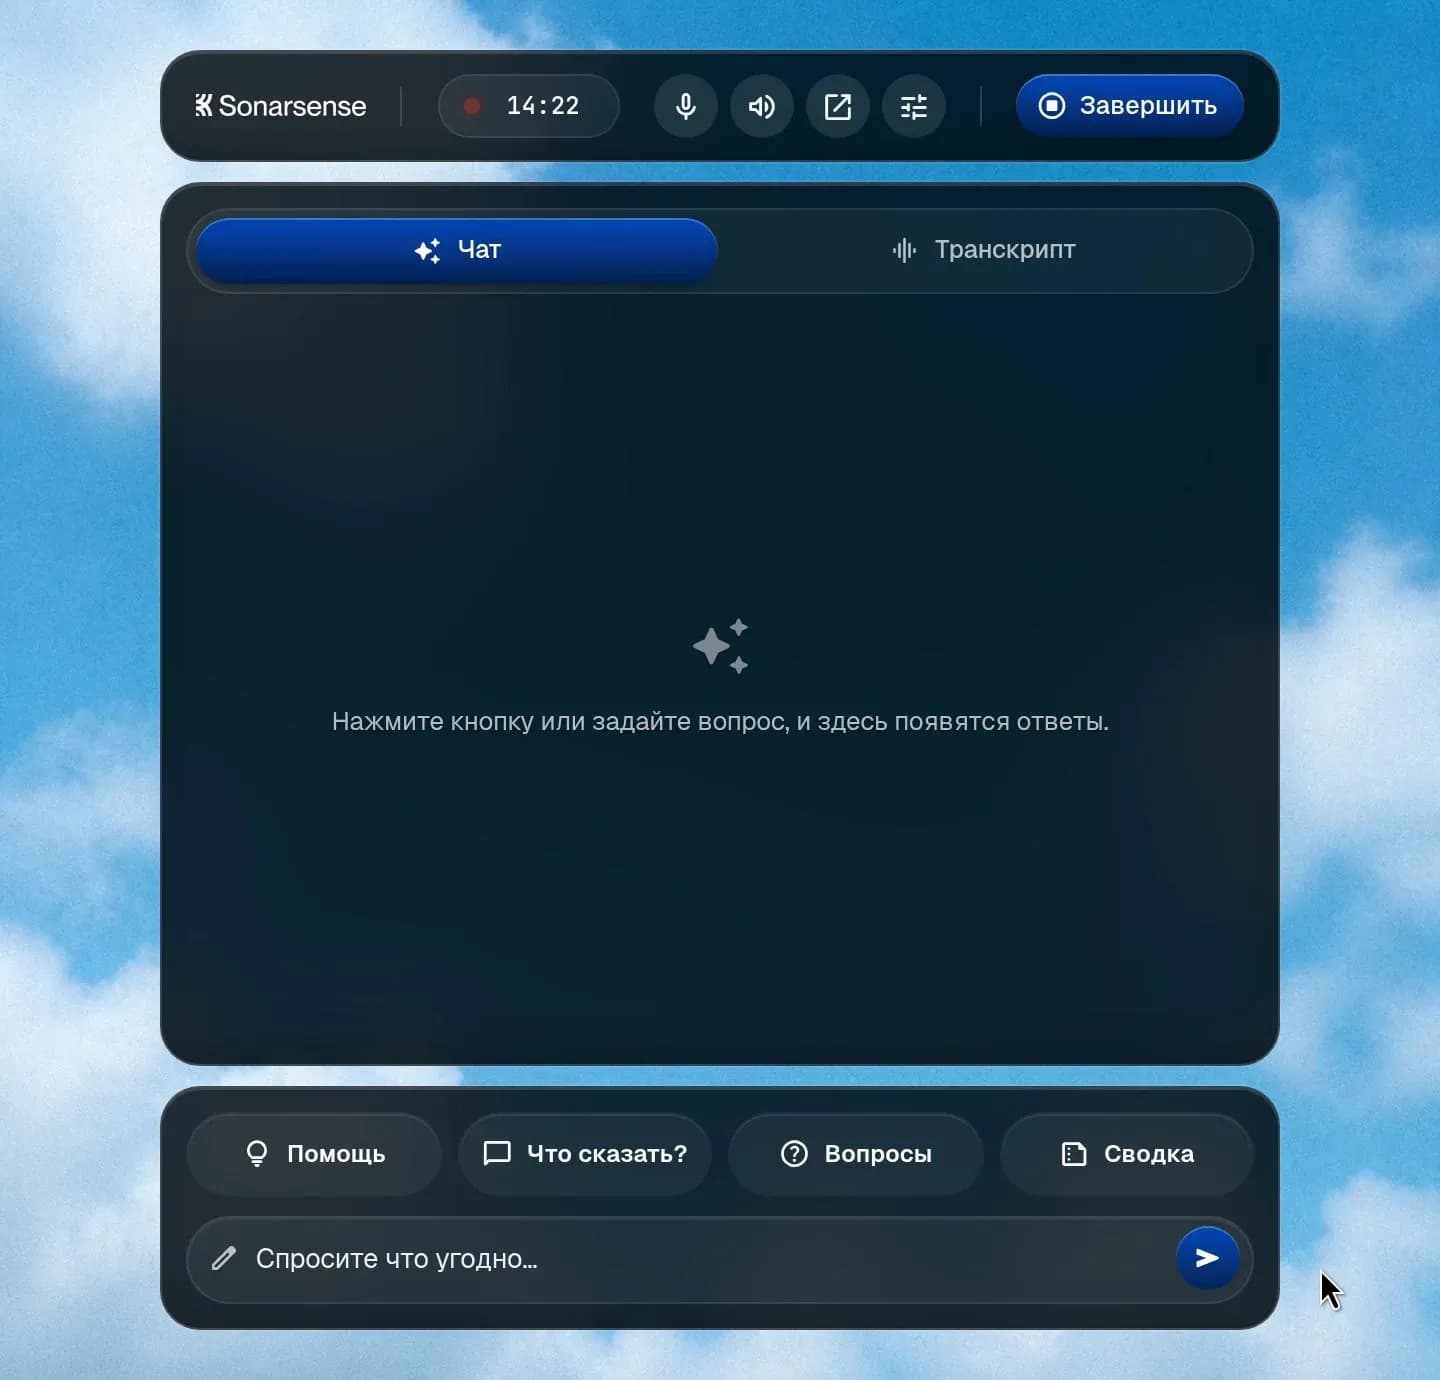
Транскрипт не является юридически точной стенограммой по умолчанию. Интерфейс должен позволять вернуться к звуку, проверить важную цитату и не скрывать неопределенность.
Об авторе
Антон Ковалевский
Маркетинг в Sonarsense.io
Пишу про то, что происходит в звонках отдела продаж, а не в отчётах CRM.